Создание инструментов с помощью командной оболочки

Open in Colab

К оглавлению курса

Сильная сторона UNIX-оболочки заключается в том, что она позволяет комбинировать программы для создания конвейеров), способных обрабатывать большие объемы данных.

В этом уроке показано, как это сделать и как повторять команды для автоматической обработки любого количества файлов.

Мы продолжим работу в проекте zipf, который должен содержать следующие файлы:

zipf/
└── data
    ├── README.md
    ├── dracula.txt
    ├── frankenstein.txt
    ├── jane_eyre.txt
    ├── moby_dick.txt
    ├── sense_and_sensibility.txt
    ├── sherlock_holmes.txt
    └── time_machine.txt

Создадим такую иерархию файлов с помощью Google Colab.

Напомню, что Google Colab - это облачный сервис, предоставляющий интерфейс Jupyter Notebook, который работает на базе операционной системы GNU/Debian и позволяет обращаться к командной оболочке этой операционной системы.

Рассмотрим возможности Google Colab для работы с командной оболочкой.

Детально про командную оболочку в GNU/Linux по см. ссылке.

Запуск команд с помощью символа !

Перед командами ставится символ !:

In [19]:
!pwd
!ls
/content
sample_data  zipf

Запуск команд с помощью %%shell

Магическая команда %%shell превращает ячейку блокнота в полноценный файл командной оболочки:

In [20]:
%%shell

pwd
ls
/content
sample_data  zipf
Out[20]:

Существует магическая команда %shell, которая превращает строку в командную оболочку:

In [21]:
%shell pwd
/content
Out[21]:

Теперь создадим структуру каталогов.

Удалим созданный ранее каталог zipf, если он был в системе:

In [ ]:
%%shell

if [ -d zipf ]; then
rm -rfv zipf
fi

Формируем структуру каталогов:

In [23]:
%%shell

mkdir zipf
cd zipf
mkdir data
cd data
wget https://raw.githubusercontent.com/dm-fedorov/pandas_basic/master/data/data.zip
unzip data.zip
pwd
ls
--2023-03-26 14:27:44--  https://raw.githubusercontent.com/dm-fedorov/pandas_basic/master/data/data.zip
Resolving raw.githubusercontent.com (raw.githubusercontent.com)... 185.199.109.133, 185.199.108.133, 185.199.110.133, ...
Connecting to raw.githubusercontent.com (raw.githubusercontent.com)|185.199.109.133|:443... connected.
HTTP request sent, awaiting response... 200 OK
Length: 1992058 (1.9M) [application/zip]
Saving to: ‘data.zip’

data.zip            100%[===================>]   1.90M  --.-KB/s    in 0.02s   

2023-03-26 14:27:44 (87.6 MB/s) - ‘data.zip’ saved [1992058/1992058]

Archive:  data.zip
  inflating: dracula.txt             
  inflating: __MACOSX/._dracula.txt  
  inflating: frankenstein.txt        
  inflating: __MACOSX/._frankenstein.txt  
  inflating: jane_eyre.txt           
  inflating: __MACOSX/._jane_eyre.txt  
  inflating: moby_dick.txt           
  inflating: __MACOSX/._moby_dick.txt  
  inflating: README.md               
  inflating: __MACOSX/._README.md    
  inflating: sense_and_sensibility.txt  
  inflating: __MACOSX/._sense_and_sensibility.txt  
  inflating: sherlock_holmes.txt     
  inflating: __MACOSX/._sherlock_holmes.txt  
  inflating: time_machine.txt        
  inflating: __MACOSX/._time_machine.txt  
/content/zipf/data
data.zip	  jane_eyre.txt  README.md		    time_machine.txt
dracula.txt	  __MACOSX	 sense_and_sensibility.txt
frankenstein.txt  moby_dick.txt  sherlock_holmes.txt
Out[23]:

Объединение команд

Чтобы увидеть, как оболочка позволяет нам комбинировать команды, давайте перейдем в каталог zipf/data и посчитаем количество строк в каждом файле.

Команда wc (сокращение от word count) сообщает, сколько строк, слов и букв содержится в одном файле:

In [24]:
%shell wc zipf/data/moby_dick.txt
  22331  215832 1253891 zipf/data/moby_dick.txt
Out[24]:

Только количество строк (указываем ключ -l):

In [25]:
%shell wc -l zipf/data/moby_dick.txt
22331 zipf/data/moby_dick.txt
Out[25]:

Мы можем использовать wildcard (подстановочные символы), чтобы сразу указать набор файлов. Чаще всего используется подстановочный символ * (одна звездочка). Он соответствует нулю или более символов, поэтому zipf/data/*.txt соответствует всем текстовым файлам в каталоге data:

In [26]:
%shell ls zipf/data/*.txt
zipf/data/dracula.txt	    zipf/data/sense_and_sensibility.txt
zipf/data/frankenstein.txt  zipf/data/sherlock_holmes.txt
zipf/data/jane_eyre.txt     zipf/data/time_machine.txt
zipf/data/moby_dick.txt
Out[26]:

В то время как zipf/data/s*.txt соответствует только двум файлам, имена которых начинаются с s:

In [27]:
%shell ls zipf/data/s*.txt
zipf/data/sense_and_sensibility.txt  zipf/data/sherlock_holmes.txt
Out[27]:

Подстановочные символы расширяются, чтобы соответствовать именам файлов перед запуском команд, поэтому они работают одинаково для каждой команды. Это означает, что мы можем использовать их с wc для подсчета количества слов в книгах с именами, которые содержат подчеркивание:

In [28]:
%shell wc zipf/data/*_*.txt
  21054  188460 1049294 zipf/data/jane_eyre.txt
  22331  215832 1253891 zipf/data/moby_dick.txt
  13028  121593  693116 zipf/data/sense_and_sensibility.txt
  13053  107536  581903 zipf/data/sherlock_holmes.txt
   3582   35527  200928 zipf/data/time_machine.txt
  73048  668948 3779132 total
Out[28]:

Подсчет количества строк в каждом файле:

In [29]:
%shell wc -l zipf/data/*.txt
  15975 zipf/data/dracula.txt
   7832 zipf/data/frankenstein.txt
  21054 zipf/data/jane_eyre.txt
  22331 zipf/data/moby_dick.txt
  13028 zipf/data/sense_and_sensibility.txt
  13053 zipf/data/sherlock_holmes.txt
   3582 zipf/data/time_machine.txt
  96855 total
Out[29]:

Какая из этих книг самая короткая?

Мы можем проверить на глаз, когда файлов всего семь, а если бы их было восемь тысяч?

Наш первый шаг к решению — запустить команду:

In [30]:
%%shell

cd zipf/data
wc -l *.txt > lengths.txt
Out[30]:

Символ "больше" > указывает оболочке перенаправить вывод команды в файл, а не печатать его. На экране ничего не появляется; вместо этого все, что могло появиться, ушло в файл lengths.txt. Оболочка создает этот файл, если он не существует, или перезаписывает его, если он уже существует.

Мы можем распечатать содержимое файла lengths.txt, используя cat, что является сокращением от con cat enate (потому что, если мы дадим ему имена нескольких файлов, он напечатает их все по порядку):

In [31]:
%%shell

cat zipf/data/lengths.txt
  15975 dracula.txt
   7832 frankenstein.txt
  21054 jane_eyre.txt
  22331 moby_dick.txt
  13028 sense_and_sensibility.txt
  13053 sherlock_holmes.txt
   3582 time_machine.txt
  96855 total
Out[31]:

Теперь мы можем использовать sort для сортировки строк в этом файле:

In [32]:
%%shell

sort -n zipf/data/lengths.txt
   3582 time_machine.txt
   7832 frankenstein.txt
  13028 sense_and_sensibility.txt
  13053 sherlock_holmes.txt
  15975 dracula.txt
  21054 jane_eyre.txt
  22331 moby_dick.txt
  96855 total
Out[32]:

На всякий случай мы используем в sort опцию -n, чтобы указать, что мы хотим сортировать по числам.

sort не изменяет lengths.txt. Вместо этого она отправляет свой вывод на экран так же, как wc ранее. Поэтому мы можем поместить отсортированный список строк в другой временный файл sorted-lengths.txt с помощью >:

In [33]:
%%shell

cd zipf/data
sort -n lengths.txt > sorted-lengths.txt
Out[33]:

Создание промежуточных файлов с именами типа lengths.txt и sorted-lengths.txt работает, но отслеживать эти файлы и очищать их, когда они больше не нужны, — утомительное занятие.

Давайте удалим два файла, которые мы только что создали:

In [34]:
%%shell

cd zipf/data
rm lengths.txt sorted-lengths.txt
Out[34]:

Мы можем получить тот же результат с меньшим количеством ввода, используя канал (pipe):

In [35]:
%%shell

cd zipf/data
wc -l *.txt | sort -n
   3582 time_machine.txt
   7832 frankenstein.txt
  13028 sense_and_sensibility.txt
  13053 sherlock_holmes.txt
  15975 dracula.txt
  21054 jane_eyre.txt
  22331 moby_dick.txt
  96855 total
Out[35]:

Вертикальная черта | между командами wc и sort сообщает оболочке, что мы хотим использовать выходные данные команды слева в качестве входных данных для команды справа.

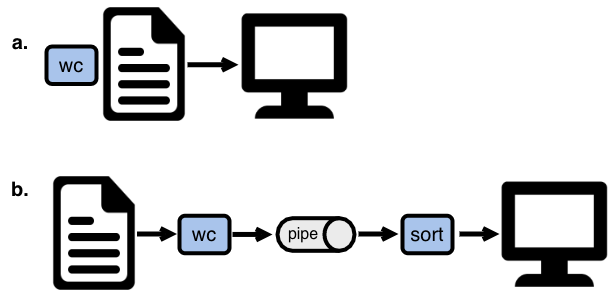
Выполнение команды с файлом в качестве входных данных имеет четкий поток информации: команда выполняет задачу над этим файлом и выводит результат на экран (рис. 3.1 а).

Однако при использовании каналов (pipe) информация иначе передается после первой команды. Вышестоящая по течению данных команда не читает из файла. Вместо этого она считывает вывод команды, находящейся ниже по течению (рис. 3.1 б).

pipe

Рисунок 3.1: Команды, связанные каналом

Мы можем использовать | для сборки каналов любой длины. Например, мы можем использовать команду head, чтобы получить только первые три строки отсортированных данных, которые показывают нам три самые короткие книги:

In [36]:
%shell wc -l zipf/data/*.txt | sort -n | head -n 3
   3582 zipf/data/time_machine.txt
   7832 zipf/data/frankenstein.txt
  13028 zipf/data/sense_and_sensibility.txt
Out[36]:

Мы всегда можем перенаправить вывод в файл, добавив > shortest.txt в конец канала, тем самым сохранив ответ для дальнейшего использования.

На практике большинство Unix-пользователей создавали бы этот конвейер шаг за шагом, как и мы: начиная с одной команды и добавляя другие команды одну за другой, проверяя вывод после каждого изменения.

telegram Обсудить публикацию в [Telegram-канале]


Источник:
"Research Software Engineering with Python. Building software that makes research possible" by Damien Irving, Kate Hertweck, Luke Johnston, Joel Ostblom, Charlotte Wickham, Greg Wilson, https://merely-useful.tech/py-rse/, CC-BY 4.0 и MIT License.